Buch Lustmarsch durchs Theoriegelände
– Musealisiert Euch!
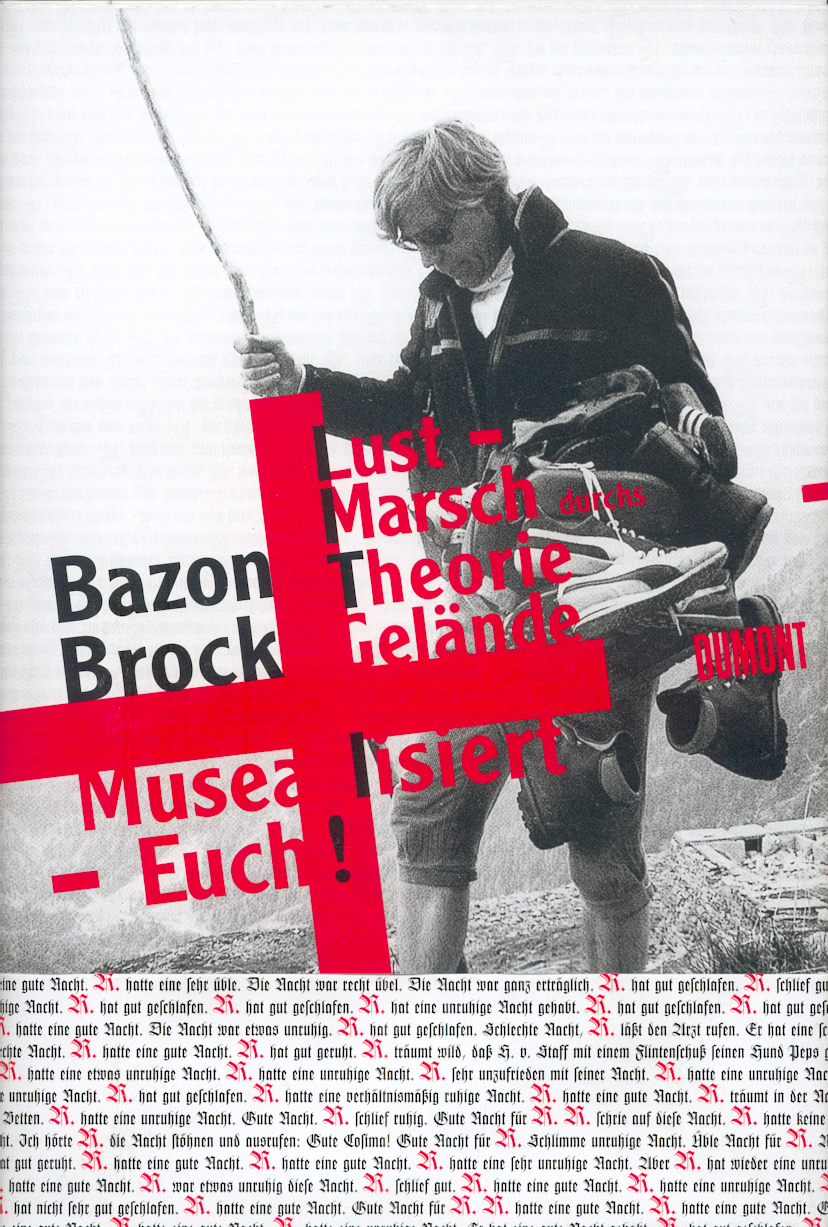 + 4 Bilder
Gestaltung: botschaft prof. gertrud nolte
Das Buch ist mit einem Plakat-Umschlag in den Maßen 58 cm x 79 cm eingeschlagen.
– Musealisiert Euch!
+ 4 Bilder
Gestaltung: botschaft prof. gertrud nolte
Das Buch ist mit einem Plakat-Umschlag in den Maßen 58 cm x 79 cm eingeschlagen.
Abschnitt, beginnend auf Seite 78 im Original
Es ist schon längst geboten, den Dadaismus als eine Zustimmungslehre, sprich, eine Hochzeitsphilosophie zu würdigen. Bei der Hochzeit stellt sich für den Bräutigam und die Braut die zentrale Frage nach dem Ja-Sagen. Beide Parteien wissen von vornherein, daß sie im Grunde nicht wissen, wozu sie am Altar ihr Ja-Wort geben. Das ist der tiefere Sinn des Hochzeits-Ja als einer kulturell vermittelten und institutionell abgesicherten Form der Unerfahrbarkeit, der Unerwartbarkeit, der Nichtantizipierbarkeit dessen, was kommt, das Einverständnis zu signalisieren. Der Dadaist, als ewiger Bräutigam und wahrer Heros des Ja, bekundet also, den Irrsinn zu ertragen, den Wahnsinn walten zu lassen und das Lächeln der Etrusker einzuüben.
Jeder Streifen repräsentiert einen Textabschnitt in der Arbeitsbiografie. Je heller ein Streifen, desto verwandter ist der Text mit dem aktuellen Text. Der aktuelle Werk hat die Farbe Rot, der aktuelle Abschnitt ist orange markiert.
Grundlage der Textanalyse ist das Sprachmodell MiniLM-L12 / BGE-M3. Mit dessen Hilfe wird der aktuelle Textabschnitt mit allen anderen Textabschnitten verglichen (insgesamt knapp 3 Millionen Kombinationen) und ein Ähnlichkeitskennwert berechnet.
Die Ähnlichkeit basiert nicht auf Wortgleichheit, sondern auf semantischen Eigenschaften. Beispiele:
Als ähnlich erkannt werden Synonyme, Umschreibungen und Paraphrasen sowie gleiche Bedeutungen – auch in unterschiedlichen Sprachen – erkannt. Beispiel: Kunst und Politik ⟷ art and politics.
Aktuell werden die Textverwandtschaften auf Basis des gesamten Textkorpus statisch vorberechnet und bei Änderungen einzelner Inhalte aktualisiert. In die Berechnung werden nur Textabschnitte einbezogen, die mehr als 100 Wörter Inhalt haben. Leere oder kurze Abschnitte sind daher in dieser Textgenetik nicht enthalten.
Die Verwandtschafts-Abstufungen wurden in 6 Gruppen zusammengefasst: 0 = keine Verwandtschaft, 20, 40, 60, 80, 100 = sehr nah am aktuellen Text.
Die Fundstellen in dieser Verwandtschafts-Textgenetik liefern also möglicherweise völlig andere, eventuell unerwartete Lese-Anregungen, während die zugeordneten Verweise (unter siehe auch) redaktionell ausgewählt wurden.


